排序算法总结
排序大的分类可以分为两种:内排序和外排序。在排序过程中,全部记录存放在内存,则称为内排序,如果排序过程中需要使用外存,则称为外排序。
1 内排序
这里主要介绍冒泡排序、直接插入排序、选择排序、希尔排序、归并排序、快速排序、堆排序、桶排序和基数排序。
1.1 冒泡排序
冒泡排序(Bubble Sort),又被称为气泡排序或泡沫排序。
它是一种较简单的排序算法。它会遍历若干次要排序的数列,每次遍历时,它都会从前往后依次的比较相邻两个数的大小;如果前者比后者大,则交换它们的位置。
步骤:
- 比较相邻的元素。如果第一个比第二个大,就交换他们两个。
- 对第0个到第n-1个数据做同样的工作。这时,最大的数就“浮”到了数组最后的位置上。
- 针对所有的元素重复以上的步骤,除了最后一个。
- 持续每次对越来越少的元素重复上面的步骤,直到数列达到有序为止。
版本1:原始版本,遇到就交换。
def bubble_sort(mlist, n):
    for i in range(n):
        for j in range(1,n-i):
            if mlist[j-1] > mlist[j]:
                temp = mlist[j]
                mlist[j] = mlist[j-1]
                mlist[j-1] = temp
    return mlist

if __name__ == '__main__':
    mlist = [20, 40, 30, 10, 60, 50]
    print("排序前:", mlist)
    n = len(mlist)
    print("排序后:", bubble_sort(mlist, n))

输出:
排序前: [20, 40, 30, 10, 60, 50]
排序后: [10, 20, 30, 40, 50, 60]
版本2:优化版本,某一趟遍历如果没有数据交换,则说明已经排好序了,因此不用再进行迭代了。用一个标记记录这个状态即可。
def bubble_sort(list, n):
    for i in range(n-1, 0, -1):
        flag = 0  # 标记
        for j in range(i):
            if list[j] > list[j + 1]:
                temp = list[j + 1]
                list[j + 1] = list[j]
                list[j] = temp
                flag = 1
        if flag == 0:
            break  # 全排好序了,直接跳出
    return list

if __name__ == '__main__':
    mlist = [20, 40, 30, 10, 60, 50]
    print("排序前:", mlist)
    n = len(mlist)
    print("排序后:", bubble_sort(mlist, n))

输出:
排序前: [20, 40, 30, 10, 60, 50]
排序后: [10, 20, 30, 40, 50, 60]
版本3:同样是一个优化版本,记录某次遍历时最后发生数据交换的位置,这个位置之后的数据显然已经有序,不用再排序了。因此通过记录最后发生数据交换的位置就可以确定下次循环的范围了。
def bubble_sort(mlist, n):
    k = n - 1  # k为循环下标的范围,初始值n-1
    for i in range(k, 0, -1):
        flag = 0
        for j in range(i):  # 只遍历到最后交换的位置即可
            if mlist[j] > mlist[j+1]:
                temp = mlist[j + 1]
                mlist[j + 1] = mlist[j]
                mlist[j] = temp
                flag = 1
                k = j  # 记录最后交换的位置
        if flag == 0:
            break
    return mlist

if __name__ == '__main__':
    mlist = [20, 40, 30, 10, 5, 70, 60, 50]
    print("排序前:", mlist)
    n = len(mlist)
    print("排序后:", bubble_sort(mlist, n))

输出:
排序前: [20, 40, 30, 10, 5, 70, 60, 50]
排序后: [5, 10, 20, 30, 40, 50, 60, 70]
最后来一个Java版本的冒泡排序。
public class BubbleSort {

	public void bubbleSort(int[] a, int n) {
		int flag; // 标记是否发生交换
		int i,j;
		for (i = n-1; i > 0; i--) {
			flag = 0;
			for (j = 0; j < i; j++) {
				if (a[j] > a[j+1]) {
					int tmp = a[j];
					a[j] = a[j+1];
					a[j+1] = tmp;
					flag = 1; // 发生交换
				}
			}
			if (flag == 0) {
				break; // 若没发生交换,则说明数列已有序。
			}
		}
	}

	public static void main(String[] args) {
		BubbleSort bSort = new BubbleSort();
		int[] a = {20,40,30,10,60,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		bSort.bubbleSort(a, a.length);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}

}

输出:
排序前:20 40 30 10 60 50
排序后:10 20 30 40 50 60
1.2 直接插入排序
直接插入排序(Straight Insertion Sort)的基本思想是:把n个待排序的元素看成为一个有序表和一个无序表。开始时有序表中只包含1个元素,无序表中包含有n-1个元素,排序过程中每次从无序表中取出第一个元素,将它插入到有序表中的适当位置,使之成为新的有序表,重复n-1次可完成排序过程。
步骤:
- 从第一个元素开始,该元素可以认为已经被排序
- 取出下一个元素,在已经排序的元素序列中从后向前扫描
- 如果被扫描的元素(已排序)大于新元素,将该元素后移一位
- 重复步骤3,直到找到已排序的元素小于或者等于新元素的位置
- 将新元素插入到该位置后
- 重复步骤2~5
def insert_sort(mlist, n):
    for i in range(1, n):
        key = mlist[i]  # 待插入的数据
        j = i - 1  # 有序表中的最大下标
        while j >= 0:  # 在有序表中找到待插入数据插入的位置
            if key < mlist[j]:
                mlist[j + 1] = mlist[j]
                mlist[j] = key
                j -= 1
            else:
                break
    return mlist

if __name__ == '__main__':
    mlist = [20, 40, 30, 10, 60, 50]
    print("排序前:", mlist)
    print("排序后:", insert_sort(mlist, len(mlist)))

输出:
排序前: [20, 40, 30, 10, 60, 50]
排序后: [10, 20, 30, 40, 50, 60]
最后来一个Java版本的直接插入排序。
public class InsertSort {

	public void insertSort(int[] a, int n) {
		int i,j,k;
		for (i = 1; i < a.length; i++) {
			// 为a[i]在前面的a[0...i-1]有序区间中找一个合适的位置
			for (j = i - 1; j >= 0; j--) {
				if (a[j] < a[i]) {
					break;
				}
			}
			// 如找到了一个合适的位置
			if (j != i - 1) {
				// 将比a[i]大的数据向后移
				int temp = a[i];
				for (k = i - 1; k > j; k--) {
					a[k + 1] = a[k];
				}
				// 将a[i]放到正确位置上
				a[k + 1] = temp;
			}
		}
	}

	public static void main(String[] args) {
		InsertSort iSort = new InsertSort();
		int[] a = {20,40,30,10,60,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		iSort.insertSort(a, a.length);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 50
排序后:10 20 30 40 50 60
1.3 选择排序
选择排序(Selection sort)是一种简单直观的排序算法。
它的基本思想是:首先在未排序的数列中找到最小(or最大)元素,然后将其存放到数列的起始位置;接着,再从剩余未排序的元素中继续寻找最小(or最大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
步骤:
- 在未排序序列中找到最小(大)元素,存放到排序序列的起始位置。
- 再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。
- 以此类推,直到所有元素均排序完毕。
def select_sort(mlist, n):
    for i in range(n):
        min = i  # 假设一个最小值的下标
        for j in range(i + 1, n):
            if mlist[min] > mlist[j]:
                min = j  # 找到剩余的序列中更小的值的下标
        if min != i:  # 将换最小值的位置
            temp = mlist[min]
            mlist[min] = mlist[i]
            mlist[i] = temp
    return mlist

if __name__ == '__main__':
    mlist = [20, 40, 30, 10, 60, 50]
    print("排序前:", mlist)
    print("排序后:", select_sort(mlist, len(mlist)))

输出:
排序前: [20, 40, 30, 10, 60, 50]
排序后: [10, 20, 30, 40, 50, 60]
最后来一个Java版本的选择排序。
public class SelectSort {

	public void selectSort(int[] a, int n) {
		int min;  // 无序区最小的元素的位置
		for (int i = 0; i < n; i++) {
			min = i;
			// 找出"a[i+1] ... a[n]"之间的最小元素,并赋值给min。
			for (int j = i + 1; j < n; j++) {
				if (a[j] < a[i]) {
					min = j;
				}
			}
			// 若min!=i,则交换 a[i] 和 a[min]。
			// 交换之后,保证了a[0] ... a[i] 之间的元素是有序的。
			if (min != i) {
				int tmp = a[i];
				a[i] = a[min];
				a[min] = tmp;
			}
		}
	}

	public static void main(String[] args) {
		SelectSort sSort = new SelectSort();
		int[] a = {20,40,30,10,60,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		sSort.selectSort(a, a.length);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 50
排序后:10 20 30 40 50 60
1.4 希尔排序
希尔排序(Shell Sort)是插入排序的一种,它是针对直接插入排序算法的改进。该方法又称缩小增量排序。
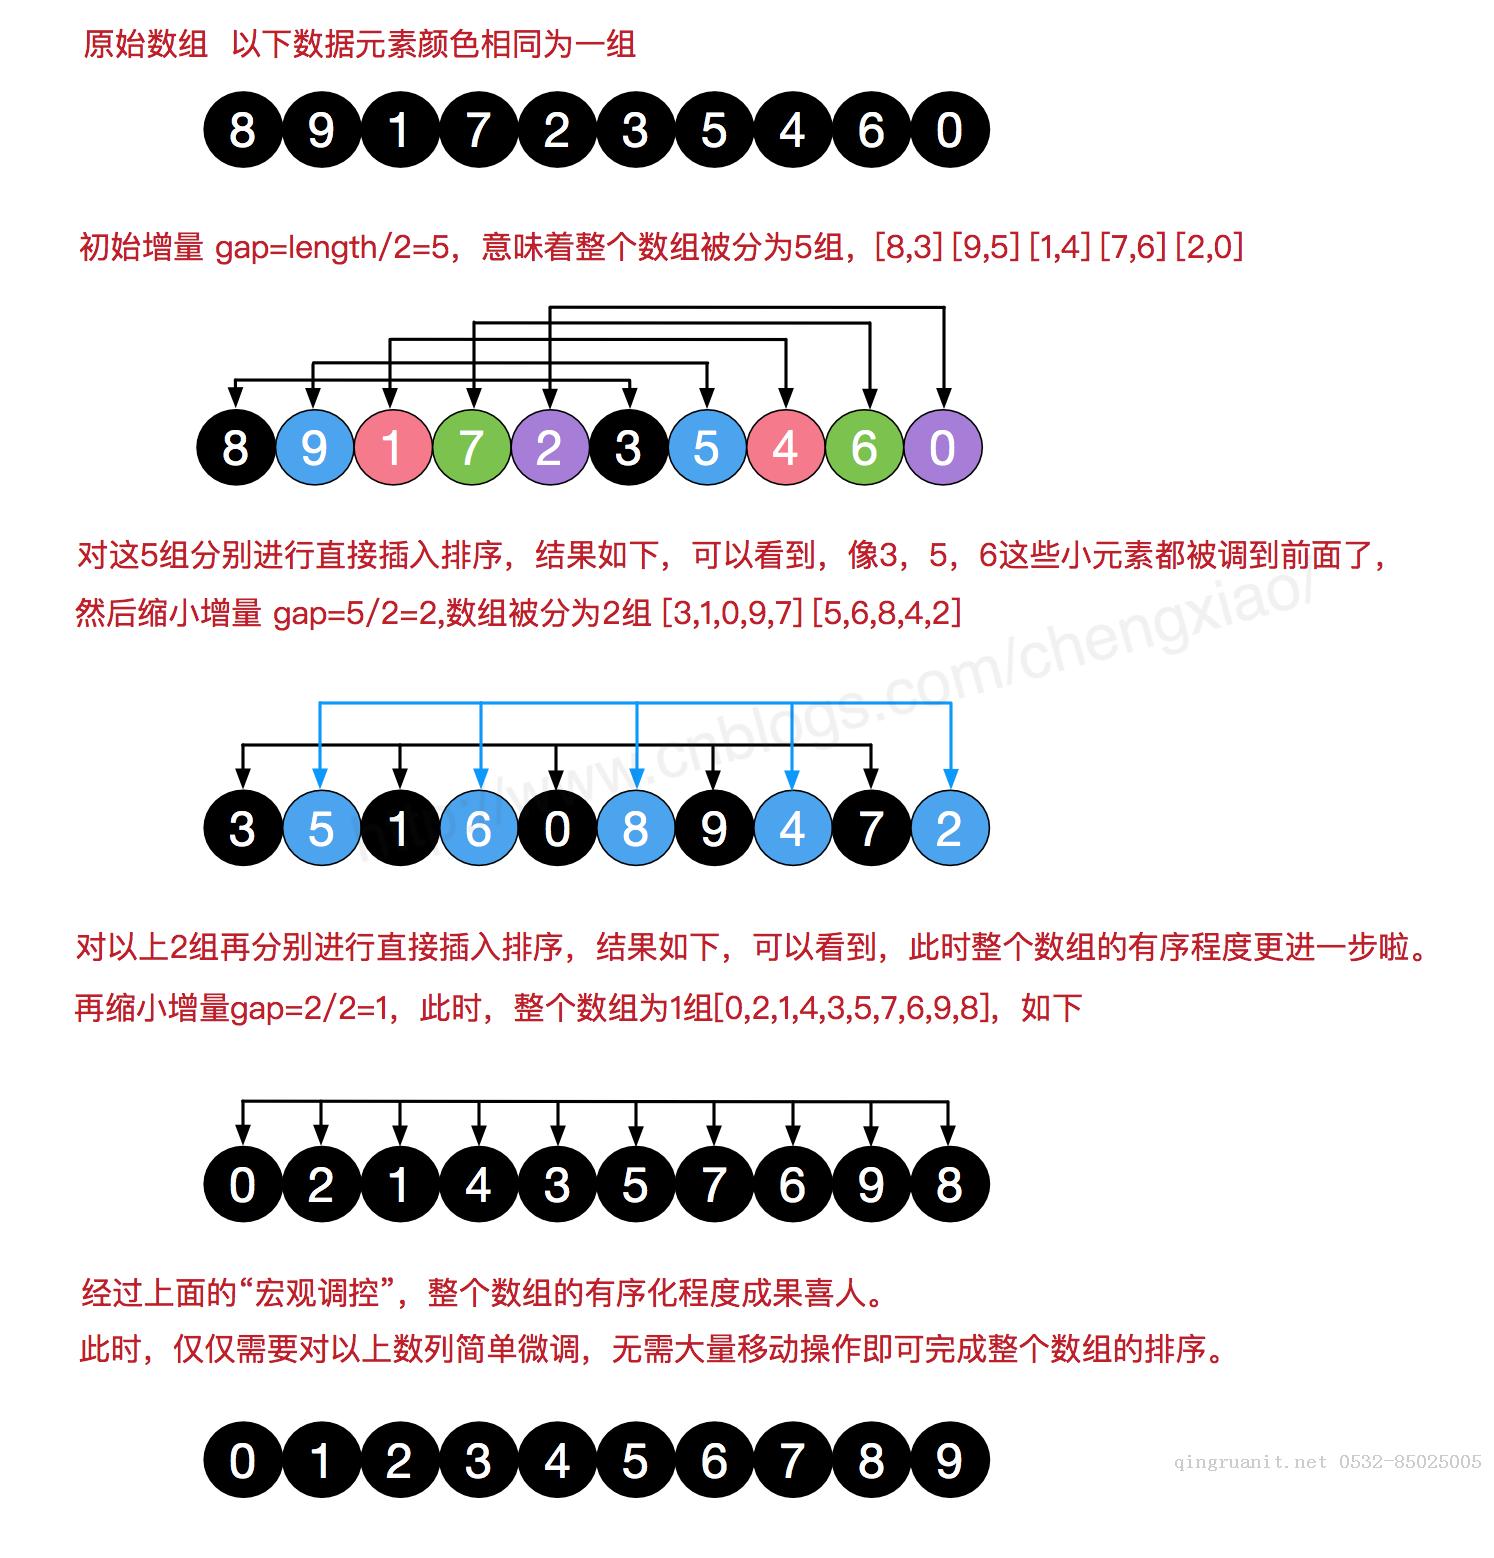
希尔排序实质上是一种分组插入方法。它的基本思想是:对于n个待排序的数列,取一个小于n的整数gap(gap被称为步长)将待排序元素分成若干个组子序列,所有距离为gap的倍数的记录放在同一个组中;然后,对各组内的元素进行直接插入排序。 这一趟排序完成之后,每一个组的元素都是有序的。然后减小gap的值,并重复执行上述的分组和排序。重复这样的操作,当gap=1时,整个数列就是有序的。
def shell_sort(mlist, n):
    gap = n // 2  # 初始步长
    while gap > 0:
        for i in range(gap,n):  # 每一列进行插入排序 , 从gap 到 n-1
            tmp = mlist[i]
            j = i
            while (j >= gap) and (mlist[j - gap] > tmp):  # 直接插入排序
                mlist[j] = mlist[j - gap]
                j = j - gap
            mlist[j] = tmp
        gap = gap // 2
    return mlist

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    print("排序前:", mlist)
    print("排序后:", shell_sort(mlist, len(mlist)))

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的希尔排序。
public class ShellSort {

	public void shellSort(int[] a, int n) {
		// gap为步长,每次减为原来的一半
		for (int gap = n / 2; gap > 0 ; gap /= 2) {
			// 每一列进行插入排序 , 从gap 到 n-1
			for (int i = gap; i < a.length; i++) {
				int tmp = a[i];
				int j = i;
				// 直接插入排序
				while (j >= gap && a[j-gap] > tmp) {
					a[j] = a[j - gap];
					j -= gap;
				}
				a[j] = tmp;
			}
		}
	}

	public static void main(String[] args) {
		ShellSort sSort = new ShellSort();
		int[] a = {20,40,30,10,60,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		sSort.shellSort(a, a.length);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 50
排序后:10 20 30 40 50 60
1.5 归并排序
将两个的有序数列合并成一个有序数列,我们称之为”归并”。
归并排序是采用分治法的一个非常典型的应用。归并排序的思想就是先递归分解数组,再合并数组。
先考虑合并两个有序数组,基本思路是比较两个数组的最前面的数,谁小就先取谁,取了后相应的指针就往后移一位。然后再比较,直至一个数组为空,最后把另一个数组的剩余部分复制过来即可。
再考虑递归分解,基本思路是将数组分解成left和right,如果这两个数组内部数据是有序的,那么就可以用上面合并数组的方法将这两个数组合并排序。如何让这两个数组内部是有序的?可以再二分,直至分解出的小组只含有一个元素时为止,此时认为该小组内部已有序。然后合并排序相邻二个小组即可。
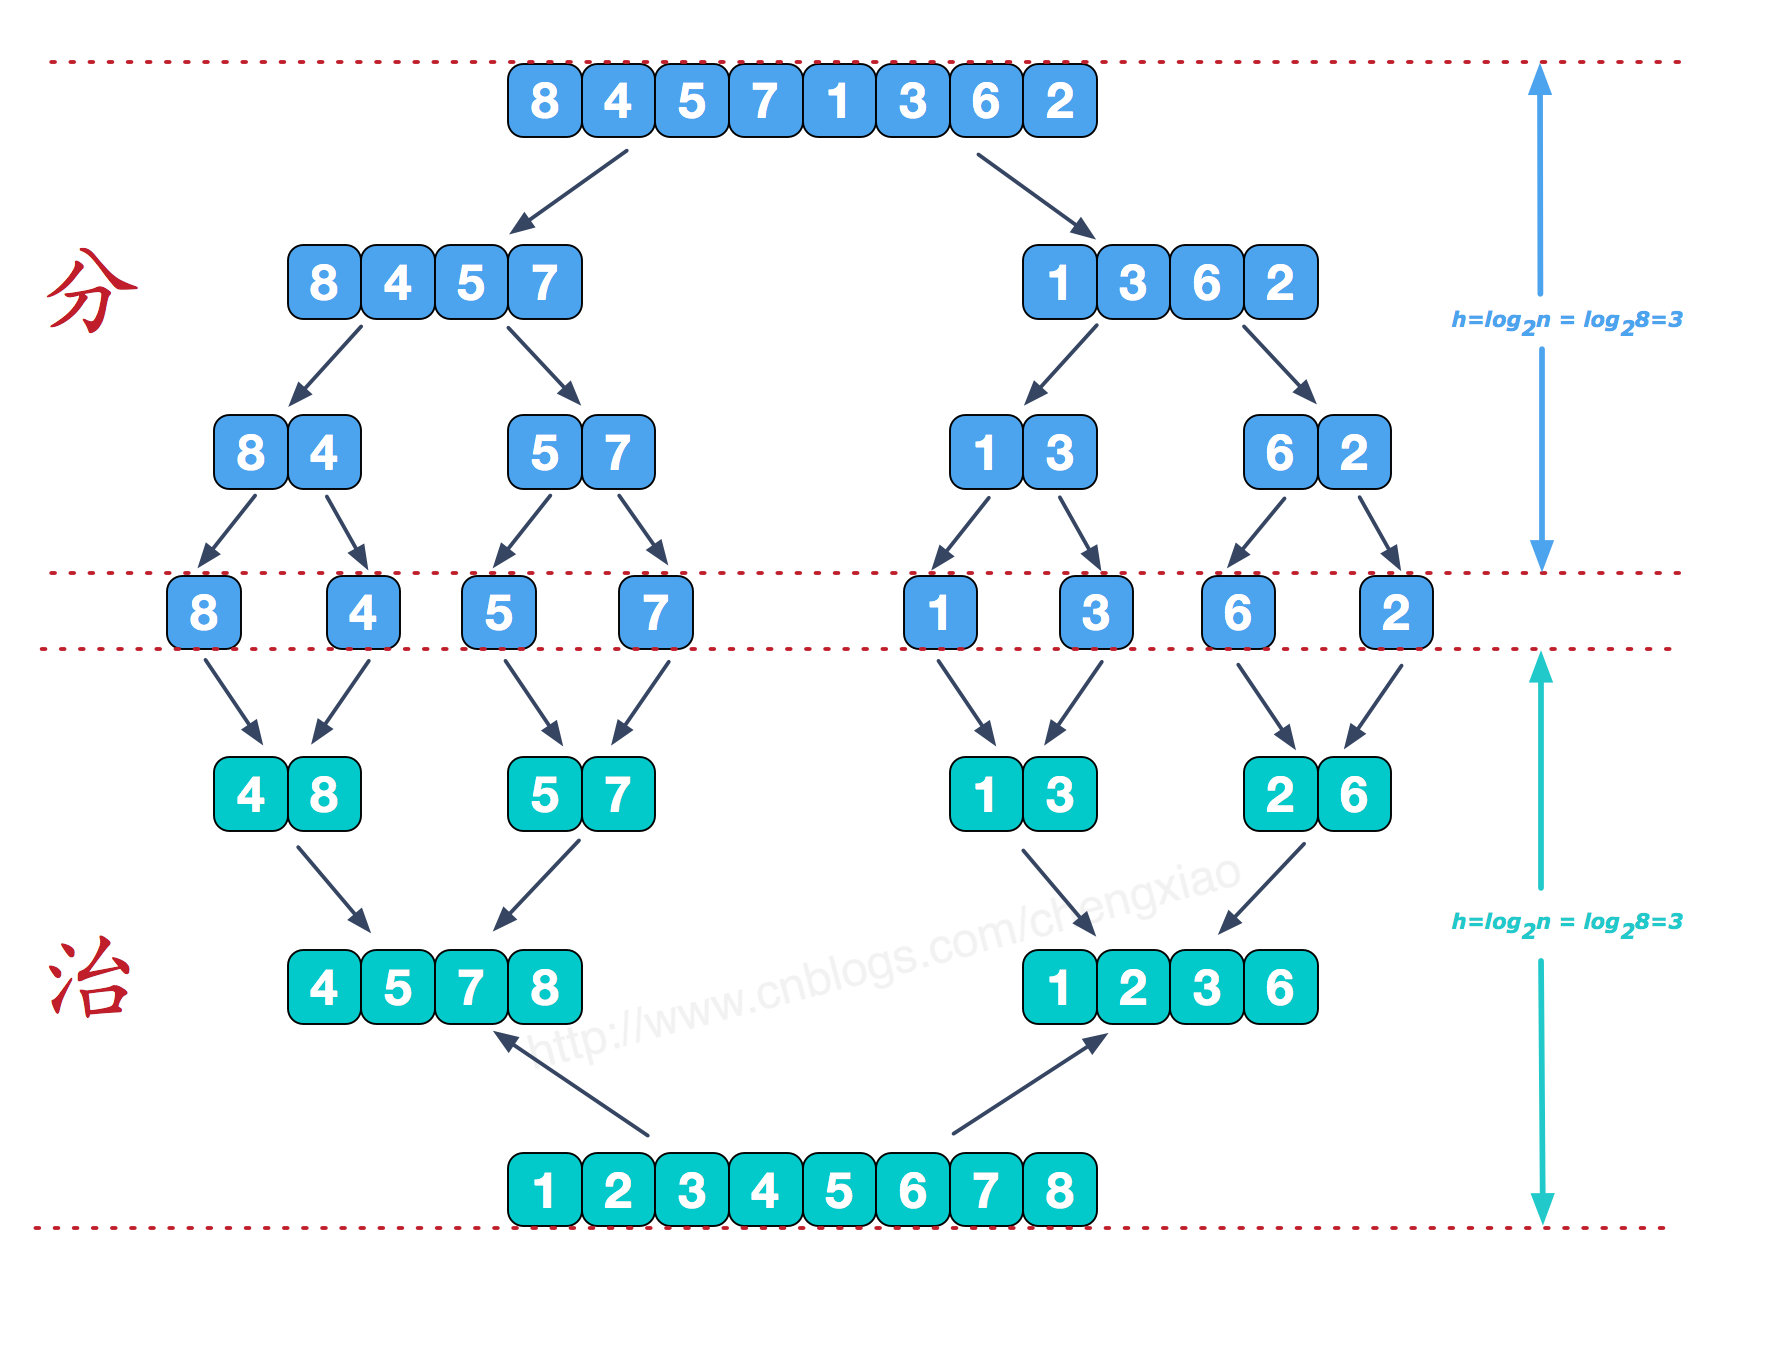
再来看看治阶段,我们需要将两个已经有序的子序列合并成一个有序序列,比如上图中的最后一次合并,要将[4,5,7,8]和[1,2,3,6]两个已经有序的子序列,合并为最终序列[1,2,3,4,5,6,7,8],来看下实现步骤。
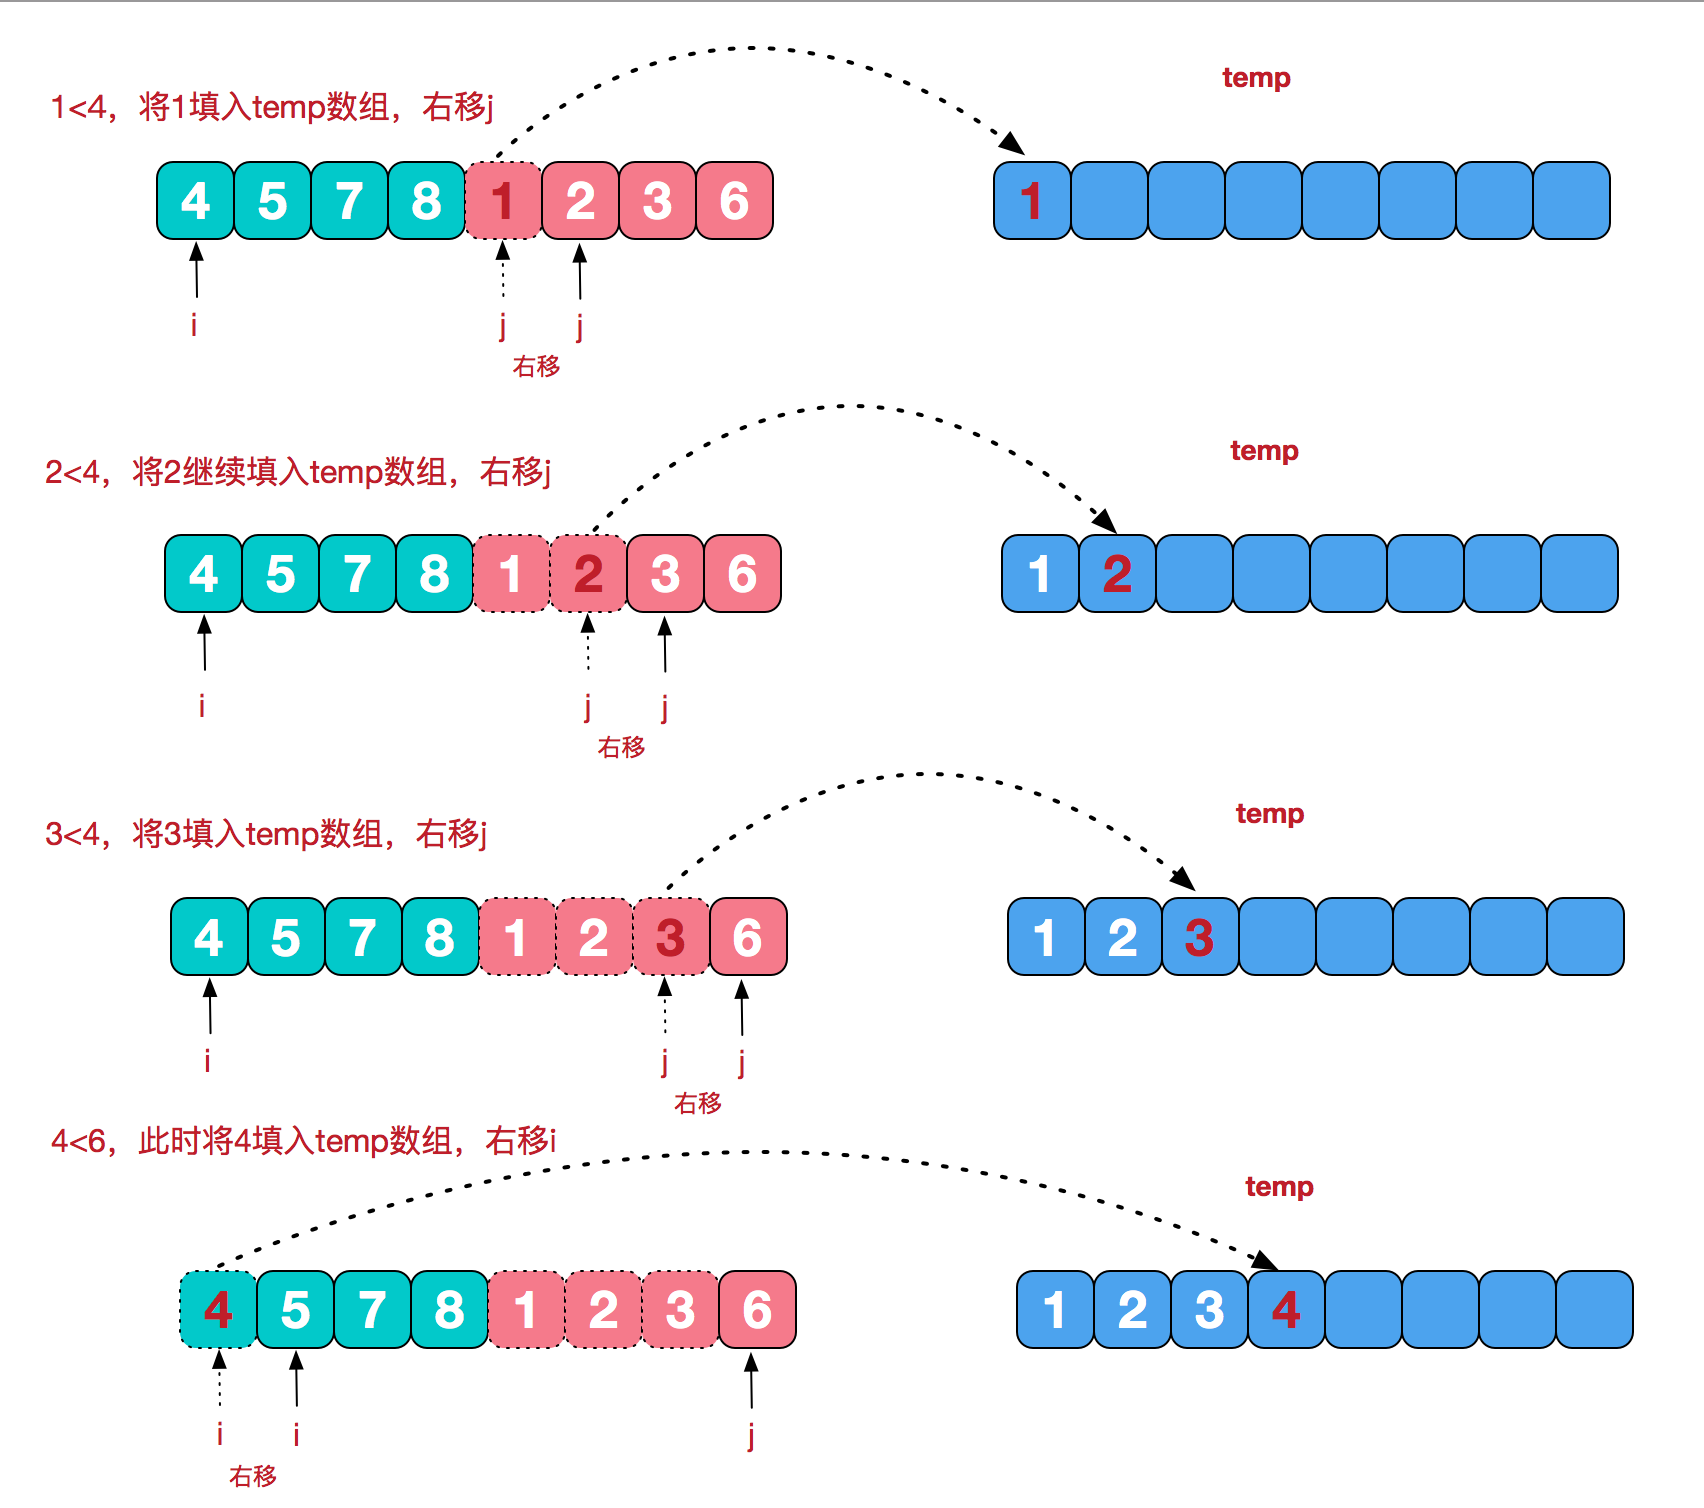
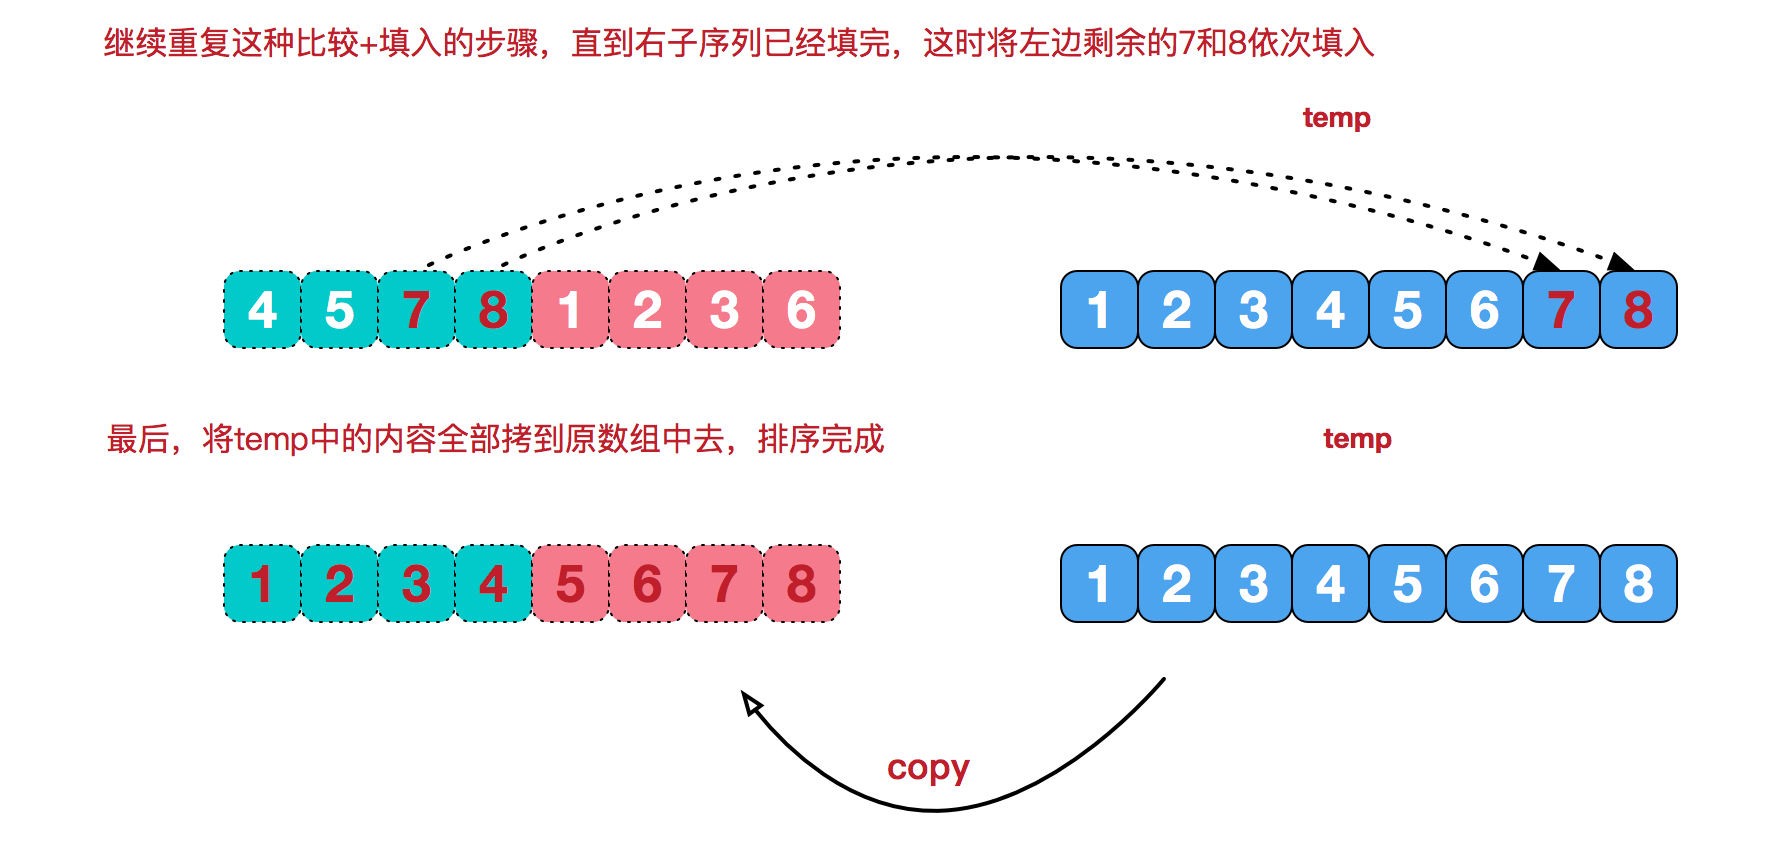 归并排序的实现方法可以使用递归或迭代。
递归法(Top-down)
- 申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列
- 设定两个指针,最初位置分别为两个已经排序序列的起始位置
- 比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置
- 重复步骤3直到某一指针到达序列尾
- 将另一序列剩下的所有元素直接复制到合并序列尾
迭代法(Bottom-up)
原理如下(假设序列共有$n$个元素):
- 将序列每相邻两个数字进行归并操作,形成
$ceil(n/2)$个序列,排序后每个序列包含两/一个元素 - 若此时序列数不是1个则将上述序列再次归并,形成
$ceil(n/4)$个序列,每个序列包含四/三个元素 - 重复步骤2,直到所有元素排序完毕,即序列数为1
# 递归实现
def merge_sort(mlist):
    length = len(mlist)
    if length == 1:
        return mlist
    else:
        mid = length // 2  # 将序列拆分成左右两个序列
        left = merge_sort(mlist[:mid])  # 对左序列进行递归调用归并排序
        right = merge_sort(mlist[mid:])  # 对右序列进行递归调用归并排序
        return merge(left, right)  # 合并左右序列

# 迭代实现
def merge_sort(mlist):
    length = len(mlist)
    step = 1
    while step < length:
        # 直接先将 mlist分成 step个数为一个数列的样子,然后依次对先后的数列进行两两合并
        for left in range(0,length-step,2*step):
            # 合并操作
            result = merge(mlist[left:left+step],mlist[left+step:min(left+2*step, length)])
            # 两两合并后需要将合并后的list与原 list合并
            mlist = mlist[:left] + result + mlist[min(left+2*step, length):]
        step = step * 2  # 这是单个 list中的数字变成最多 2*step个
    return mlist

# 合并过程
def merge(left, right):
    result = []  # 初始化一个空的 list用来放 left和 right合并后的 list
    i, j = 0, 0
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1
    result += left[i:]
    result += right[j:]
    return result

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    print("排序前:", mlist)
    print("排序后:", merge_sort(mlist))

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的归并排序。
public class MergeSort {

	// 递归版本
	public void mergeSort(int[] a, int start, int end) {
		if (a == null || start >= end) {
			return;
		}
		int mid = (end + start) / 2;  // 将序列拆分成左右两个序列
		mergeSort(a, start, mid);  // 对左序列进行递归调用归并排序
		mergeSort(a, mid+1, end);  // 对右序列进行递归调用归并排序
		merge(a,  start, mid, end);  // 合并左右序列
	}

	// 迭代版本
	public void mergeSort(int[] a) {
		int step;
		int j;
		// 对数组 a 做若干次合并:数组 a 的总长度为 a.length,将它分为若干个长度为 step 的子数组
		for (step = 1; step < a.length; step *= 2) {
			// 将"每2个相邻的子数组" 进行合并排序。
			for (j = 0;j+2*step-1 < a.length; j+= (2*step)) {
				merge(a, j, j+step-1, j+2*step-1);
			}
			// 若 j+step-1 < a.length-1,则剩余一个子数组没有配对。
		    // 将该子数组合并到已排序的数组中。
			if (j+step-1 < a.length-1) {
				merge(a, j, j+step-1, a.length-1);
			}
		}
	}

	// 合并操作
	public void merge(int[] a, int start, int mid, int end) {
		int[] tmp = new int[end-start+1]; // 临时序列用来存储两个有序序列合并后的序列
		int i = start;  // 第1个有序序列的索引
		int j = mid + 1;  // 第2个有序序列的索引
		int k = 0;  // 临时序列的索引
		while (i <= mid && j <= end) {
			if (a[i] <= a[j]) {
				tmp[k++] = a[i++];
			}else {
				tmp[k++] = a[j++];
			}
		}
		while (i <= mid) {
			tmp[k++] = a[i++];
		}
		while (j <= end) {
			tmp[k++] = a[j++];
		}
		// 将排序后的元素全部整合到数组a中
		for (i = 0; i < k; i++) {
			a[start+i] = tmp[i];
		}
	}


	public static void main(String[] args) {
		MergeSort mSort = new MergeSort();
		int[] a = {20,40,30,10,60,7,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
//		mSort.mergeSort(a, 0, a.length-1);
		mSort.mergeSort(a);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 7 50
排序后:7 10 20 30 40 50 60
1.6 快速排序
快速排序(Quick Sort)使用分治法策略。
它的基本思想是:选择一个基准数,通过一趟排序将要排序的数据分割成独立的两部分;其中一部分的所有数据都比另外一部分的所有数据都要小。然后,再按此方法对这两部分数据分别进行快速排序,整个排序过程可以递归进行,以此达到整个数据变成有序序列。
步骤:
- 从数列中挑出一个基准值。
- 将所有比基准值小的摆放在基准前面,所有比基准值大的摆在基准的后面(相同的数可以到任一边);在这个分区退出之后,该基准就处于数列的中间位置。
- 递归地把”基准值前面的子数列”和”基准值后面的子数列”进行排序,直至各子数列只有一个数。
def quick_Sort(mlist, start, end):
    if start < end:
        i = start
        j = end
        x = mlist[start] # 选取基准值
        while i < j:
            while i < j and x < mlist[j]:
                j = j - 1 # 从右向左找第一个小于x的数
            if i < j:
                mlist[i] = mlist[j]
                i = i + 1
            while i < j and x > mlist[i]:
                i = i + 1 # 从左向右找第一个大于x的数
            if i < j:
                mlist[j] = mlist[i]
                j = j - 1
        mlist[i] = x
        quick_Sort(mlist, start, i - 1)
        quick_Sort(mlist, i + 1, end)
    return mlist

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    print("排序前:", mlist)
    print("排序后:", quick_Sort(mlist, 0, len(mlist) - 1))

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的快速排序。
public class QuickSort {

	public void quickSort(int[] a, int start, int end) {
		if (start < end) {
			int i = start;
			int j = end;
			int x = a[start];
			while (i < j) {
				while (i < j && a[j] > x) {
					j--;  // 从右向左找第一个小于x的数
				}
				if (i < j) {
					a[i] = a[j];
					i++;
				}
				while (i <  j && a[i] < x) {
					i++;  // 从左向右找第一个大于x的数
				}
				if (i < j) {
					a[j] = a[i];
					j--;
				}
			}
			a[i] = x;  // 将x放到小于它的数和大于它的数的中间
			quickSort(a, start, i-1);
			quickSort(a, i+1, end);
		}
	}

	public static void main(String[] args) {
		QuickSort qSort = new QuickSort();
		int[] a = {20,40,30,10,60,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		qSort.quickSort(a, 0, a.length-1);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 50
排序后:10 20 30 40 50 60
1.7 堆排序
堆排序在top K问题中使用比较频繁。堆排序是采用二叉堆的数据结构来实现的,虽然实质上还是一维数组。二叉堆是一个近似完全二叉树 。
堆分为”最大堆”和”最小堆”。最大堆通常被用来进行”升序”排序,而最小堆通常被用来进行”降序”排序。
堆具有以下性质:
- 堆中任意节点的值总是不大于(不小于)其子节点的值;
- 堆总是一棵完全树。
将任意节点不大于其子节点的堆叫做最小堆或小根堆,而将任意节点不小于其子节点的堆叫做最大堆或大根堆。
二叉堆:二叉堆是完全二元树或者是近似完全二元树,它分为两种:最大堆和最小堆。
- 最大堆:父结点的键值总是大于或等于任何一个子节点的键值;
- 最小堆:父结点的键值总是小于或等于任何一个子节点的键值。
1.7.1 最大堆进行升序
步骤:
- 初始化堆:将数列
$a[1...n]$构造成最大堆。 - 交换数据:将
$a[1]$和$a[n]$交换,使$a[n]$是$a[1...n]$中的最大值;然后将$a[1...n-1]$重新调整为最大堆。 接着,将$a[1]$和$a[n-1]$交换,使$a[n-1]$是$a[1...n-1]$中的最大值;然后将$a[1...n-2]$重新调整为最大值。 依次类推,直到整个数列都是有序的。
def max_percDown(data, i, n):
    l = i * 2 + 1 # 左孩子的位置
    while l <= n:
        # 当存在左右孩子,取大的值的索引
        if (l < n) and (data[l] < data[l + 1]):
            l += 1
        # 比较该节点的值与最大子节点的值
        if data[i] < data[l]:
            temp = data[l]
            data[l] = data[i]
            data[i] = temp
            i = l  # 更新当前节点的索引
            l = 2 * l + 1  # 更新当前节点的左孩子的索引
        else:
            break

def heap_sort(data, n):
    # 初始化最大堆
    i = n // 2 - 1
    while i >= 0:
        max_percDown(data, i, n-1)
        i -= 1
    # 交换数据
    for i in range(n-1,-1,-1):
        temp = data[0]
        data[0] = data[i]
        data[i] = temp
        max_percDown(data, 0, i-1)

if __name__ == '__main__':
    data = [10, 40, 30, 60, 90, 70, 20, 50, 80]
    print("排序前:", data)
    n = len(data)
    heap_sort(data, n)
    print("排序后:", data)

输出:
排序前: [10, 40, 30, 60, 90, 70, 20, 50, 80]
排序后: [10, 20, 30, 40, 50, 60, 70, 80, 90]
1.7.2 最小堆进行降序
步骤和使用最大堆进行升序类似。这里就不在赘述。
def min_percDown(data, i, n):
    l = i * 2 + 1
    while l <= n:
        if (l < n) and (data[l] > data[l + 1]):
            l += 1
        if data[i] > data[l]:
            temp = data[l]
            data[l] = data[i]
            data[i] = temp
            i = l
            l = 2 * l + 1
        else:
            break

def heap_sort(data, n):
    i = n // 2 - 1
    while i >= 0:
        min_percDown(data, i, n-1)
        i -= 1
    for i in range(n-1,-1,-1):
        temp = data[0]
        data[0] = data[i]
        data[i] = temp
        min_percDown(data, 0, i-1)

if __name__ == '__main__':
    data = [10, 40, 30, 60, 90, 70, 20, 50, 80]
    print("排序前:", data)
    n = len(data)
    heap_sort(data, n)
    print("排序后:", data)

输出:
排序前: [10, 40, 30, 60, 90, 70, 20, 50, 80]
排序后: [90, 80, 70, 60, 50, 40, 30, 20, 10]
最后来一个Java版本的堆排序。
public class HeapSort {

	/**
	 * 最小堆的向下调整算法
	 * @param a 待排序数组
	 * @param i 被下沉节点的索引
	 * @param n 数组长度
	 */
	public void min_percDown(int[] a, int i, int n) {
		int left = i * 2 + 1;  // 左(left)孩子的位置
		while (left <= n) {
			if (left<n && a[left] > a[left+1]) {
				left += 1;
			}
			if (a[i] > a[left]) {
				int temp = a[left];
				a[left] = a[i];
				a[i] = temp;
				i = left;
				left = left * 2 + 1;
			} else {
				break;
			}
		}
	}

	/**
	 * 堆排序(从大到小)
	 * @param a
	 * @param n
	 */
	public void heapSortDesc(int[] a, int n) {
		int i = n / 2 - 1;
		// 构建一个最小堆
		while (i >= 0) {
			min_percDown(a, i, n-1);
			i--;
		}
		// 取出堆顶数值,和数组末尾数值交换
		// 然后将a[0,...,j]构建成一个新的最小堆
		for (int j = n-1; j >= 0; j--) {
			int temp = a[0];
			a[0] = a[j];
			a[j] = temp;
			min_percDown(a, 0, j-1);
		}
	}

	/**
	 * 最大堆的向下调整算法
	 * @param a
	 * @param i
	 * @param n
	 */
	public void max_percDown(int[] a, int i, int n) {
		int left = i * 2 + 1;  // 左(left)孩子的位置
		while (left <= n) {
			if (left<n && a[left] < a[left+1]) {
				left += 1;
			}
			if (a[i] < a[left]) {
				int temp = a[left];
				a[left] = a[i];
				a[i] = temp;
				i = left;
				left = left * 2 + 1;
			} else {
				break;
			}
		}
	}

	/**
	 * 堆排序(从小到大)
	 * @param a
	 * @param n
	 */
	public void heapSortAsc(int[] a, int n) {
		int i = n / 2 - 1;
		// 构建一个最大堆
		while (i >= 0) {
			max_percDown(a, i, n-1);
			i--;
		}
		// 取出堆顶数值,和数组末尾数值交换
		// 然后将a[0,...,j]构建成一个新的最小堆
		for (int j = n-1; j >= 0; j--) {
			int temp = a[0];
			a[0] = a[j];
			a[j] = temp;
			max_percDown(a, 0, j-1);
		}
	}

	public static void main(String[] args) {
		HeapSort hSort = new HeapSort();
		System.out.println("降序排序:");
		int[] a = {10, 40, 30, 60, 90, 70, 20, 50, 80};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		hSort.heapSortDesc(a, a.length);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		System.out.println("升序排序:");
		int[] b = {10, 40, 30, 60, 90, 70, 20, 50, 80};
		System.out.printf("排序前:");
		for (int i : b) {
			System.out.printf("%d ", i);
		}
		hSort.heapSortAsc(b, b.length);
		System.out.println();
		System.out.printf("排序后:");
		for (int i : b) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
降序排序:
排序前:10 40 30 60 90 70 20 50 80
排序后:90 80 70 60 50 40 30 20 10
升序排序:
排序前:10 40 30 60 90 70 20 50 80
排序后:10 20 30 40 50 60 70 80 90
1.8 桶排序
桶排序(Bucket Sort)的原理很简单,它是将数组分到有限数量的桶子里。
假设待排序的数组$a$中共有$N$个整数,并且已知数组$a$中数据的范围$[0, MAX)$。在桶排序时,创建容量为$MAX$的桶数组$r$,并将桶数组元素都初始化为0;将容量为$MAX$的桶数组中的每一个单元都看作一个”桶”。
在排序时,逐个遍历数组$a$,将数组$a$的值,作为”桶数组$r$“的下标。当$a$中数据被读取时,就将桶的值加1。例如,读取到数组$a[3]=5$,则将$r[5]$的值+1。
def bucker_sort(mlist, n, maxNum):
    buck = [0] * (maxNum + 1)  # 创建容量为 MAX+1的桶数组
    # 计数
    for i in range(n):
        buck[mlist[i]] += 1
    # 排序
    index = 0  # 用做排序后数组的下标
    # 依次输出buck中的数据
    for j in range(len(buck)):
        while buck[j] > 0:
            mlist[index] = j
            buck[j] -= 1
            index += 1
    return mlist

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    maxNum = max(mlist)
    print("排序前:", mlist)
    print("排序后:", bucker_sort(mlist, len(mlist), maxNum))

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的桶排序。
public class BucketSort {

	public void buckSort(int[] a, int n, int max) {
		// 创建一个容量为max的数组bucket,并且将bucket中的所有数据都初始化为0。
		int[] bucket = new int[max + 1];
		// 1. 计数
		for (int i = 0; i < a.length; i++) {
			bucket[a[i]]++;
		}
		// 2. 排序
		for (int i = 0, j = 0; i < max; i++) {
			while ((bucket[i]--) > 0) {
				a[j++] = i;
			}
		}
	}

	public static void main(String[] args) {
		BucketSort bSort = new BucketSort();
		int[] a = {20,40,30,10,60,7,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		// 获得数组中最大值
		int max = a[0];
		for (int i : a) {
			if (i > max) {
				max = i;
			}
		}
		bSort.buckSort(a, a.length, max);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 7 50
排序后:7 10 20 30 40 50 50
1.9 计数排序
计数排序不是比较排序,排序的速度快于任何比较排序算法。
由于用来计数的数组C的长度取决于待排序数组中数据的范围(等于待排序数组的最大值与最小值的差加上1),这使得计数排序对于数据范围很大的数组,需要大量内存。计数排序是用来排序0到100之间的数字的最好的算法,但是它不适合按字母顺序排序人名。但是,计数排序可以用在基数排序中的算法来排序数据范围很大的数组。
计数排序的思想是,对每一个输入元素,计算小于它的元素个数,如果有10个元素小于它,那么它就应该放在11的位置上,如果有17个元素小于它,它就应该放在18的位置上。当有几个元素相同时,这一方案要略做修改,因为不能把它们放在同一个输出位置上。下图展示了实际的运行过程。
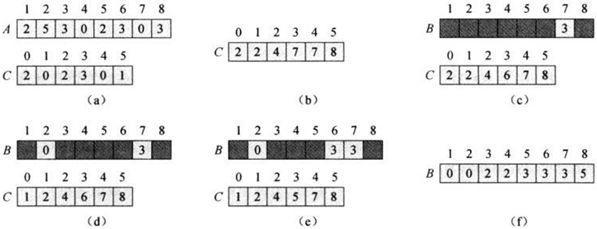
构造辅助数组C,C的长度为k。第一次遍历A后,得到[0,k)区间上每个数出现的次数,将这些次数写入C,得到图(a)的结果。然后把C中每个元素变成前面所有元素的累加和,得到图(b)的结果。接下来,再次从后向前遍历数组A,根据取出的元素查找C中对应下标的值,再把这个值作为下标找到B中的位置,即是该元素排序后的位置。例如,图中A的最后一个元素是3,找到C[3]是7,再令B[7]=3即可,然后顺便把C[3]减一,这是防止相同的数被放到同一个位置。
算法的步骤如下:
- 找出待排序的数组中最大和最小的元素
- 统计数组中每个值为i的元素出现的次数,存入数组C的第i项
- 对所有的计数累加(从C中的第一个元素开始,每一项和前一项相加)
- 反向填充目标数组:将每个元素i放在新数组的第C(i)项,每放一个元素就将C(i)减去1
def count_sort(mlist, n, maxNum):
    count_arr = [0] * (maxNum + 1)  # 数组count_arr,用于存储每个值出现的次数
    output = [0] * n  # 存储"被排序数据"的临时数组
    # 计数
    for i in mlist:
        count_arr[i] += 1
    # 统计数组计数,每项存前N项和,这实质为排序过程
    for i in range(1,maxNum + 1):
        count_arr[i] += count_arr[i - 1]
    # 将计数排序结果转化为数组元素的真实排序结果
    for i in range(n-1,-1,-1):
        elem = mlist[i]  # 取待排序元素
        index = count_arr[elem] - 1  # 待排序元素在有序数组中的序号
        output[index] = elem  # 将待排序元素存入结果数组中
        count_arr[elem] -= 1  # 修正排序结果,其实是针对算得元素的修正
    return output

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    maxNum = max(mlist)
    print("排序前:", mlist)
    print("排序后:", count_sort(mlist, len(mlist), maxNum))

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的计数排序。
public class CountSort {

	public void countSort(int a[], int n, int max) {
		// 数组 count_arr,用于存储每个值出现的次数
		int[] count_arr = new int[max + 1];
		// 存储"被排序数据"的临时数组
		int[] output = new int[n];
		// 计数
		for (int i = 0; i < n; i++) {
			count_arr[a[i]]++;
		}
		// 统计数组计数,每项存前N项和,这实质为排序过程
		for (int i = 1; i < max + 1; i++) {
			count_arr[i] += count_arr[i - 1];
		}
		// 将计数排序结果转化为数组元素的真实排序结果
		for (int i = n - 1; i >= 0; i--) {
			int elem = a[i]; // 取待排序元素
			int index = count_arr[elem] - 1; // 待排序元素在有序数组中的序号
			output[index] = elem; // 将待排序元素存入结果数组中
			count_arr[elem]--; // 修正排序结果,其实是针对算得元素的修正
		}
		// 将排序好的数据赋值给 a[]
		for (int i = 0; i < n; i++) {
			a[i] = output[i];
		}
	}

	public static void main(String[] args) {
		CountSort cSort = new CountSort();
		int[] a = { 20, 40, 30, 10, 60, 7, 50 };
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		// 获得数组中最大值
		int max = a[0];
		for (int i : a) {
			if (i > max) {
				max = i;
			}
		}
		cSort.countSort(a, a.length, max);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}

输出:
排序前:20 40 30 10 60 7 50
排序后:7 10 20 30 40 50 60
1.10 基数排序
基数排序(Radix Sort)是桶排序的扩展,它的基本思想是:将整数按位数切割成不同的数字,然后按每个位数分别比较。
具体做法是:将所有待比较数值统一为同样的数位长度,数位较短的数前面补零。然后,从最低位开始,依次进行一次排序。这样从最低位排序一直到最高位排序完成以后, 数列就变成一个有序序列。
def radix_sort(mlist, n, maxNum):
    # 从个位开始,对数组a按"指数"进行排序
    exp = 1  # 指数。当对数组按各位进行排序时,exp=1;按十位进行排序时,exp=10;...
    while maxNum/exp > 0:
        count_sort(mlist, n, exp)
        exp = exp * 10

# 使用计数排序
def count_sort(mlist, n, exp):
    output = [0] * n  # 存储"被排序数据"的临时数组
    bucket = [0] * 10  # 因为每一位数字都是0~9,故建立10个桶
    # 将数据出现的次数存储在bucket[]中
    for i in range(n):
        bucket[(mlist[i]//exp)%10] += 1
    # 更改bucket[i]。目的是让更改后的bucket[i]的值,是该数据在output[]中的位置。
    for i in range(1, 10):
        bucket[i] += bucket[i - 1]
    # 将数据存储到临时数组output[]中
    for i in range(n-1, -1, -1):
        output[bucket[(mlist[i]//exp)%10]-1] = mlist[i]
        bucket[(mlist[i]//exp)%10] -= 1
    # 将排序好的数据赋值给a[]
    for i in range(n):
        mlist[i] = output[i]

if __name__ == '__main__':
    mlist = [30, 40, 10, 60, 10, 20, 50]
    maxNum = max(mlist)
    print("排序前:", mlist)
    radix_sort(mlist, len(mlist), maxNum)
    print("排序后:", mlist)

输出:
排序前: [30, 40, 10, 60, 10, 20, 50]
排序后: [10, 10, 20, 30, 40, 50, 60]
最后来一个Java版本的基数排序。
public class RadixSort {

	// 使用计数排序对每个位上面的数进行排序
	private static void countSort(int[] a, int exp) {
		int[] output = new int[a.length];  // 存储"被排序数据"的临时数组
		int[] bucket = new int[10];  // 因为每一位数字都是 0~9,故建立 10个桶

		// 将数据出现的次数存储在 bucket[]中
		for (int num : a) {
			bucket[(num/exp)%10]++;
		}
		// 更改 bucket[i]。目的是让更改后的 bucket[i]的值,是该数据在 output[]中的位置。
		for (int i = 1; i < 10; i++) {
			bucket[i] += bucket[i - 1];
		}
		// 将数据存储到临时数组 output[]中
		for (int i = a.length - 1; i >= 0; i--) {
			output[bucket[(a[i]/exp)%10]-1] = a[i];
			bucket[(a[i]/exp)%10]--;
		}
		// 将排序好的数据赋值给 a[]
		for (int i = 0; i < a.length; i++) {
			a[i] = output[i];
		}
	}

	public void radixSort(int[] a, int max) {
		int exp;    // 指数。当对数组按各位进行排序时,exp=1;按十位进行排序时,exp=10;...
		// 从个位开始,对数组 a按"指数"进行排序
		for (exp = 1; max/exp > 0; exp *= 10) {
			countSort(a, exp);
		}
	}

	public static void main(String[] args) {
		RadixSort rSort = new RadixSort();
		int[] a = {20,40,30,10,60,7,50};
		System.out.printf("排序前:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
		System.out.println();
		// 获得数组中最大值
		int max = a[0];
		for (int i : a) {
			if (i > max) {
				max = i;
			}
		}
		rSort.radixSort(a, max);
		System.out.printf("排序后:");
		for (int i : a) {
			System.out.printf("%d ", i);
		}
	}
}
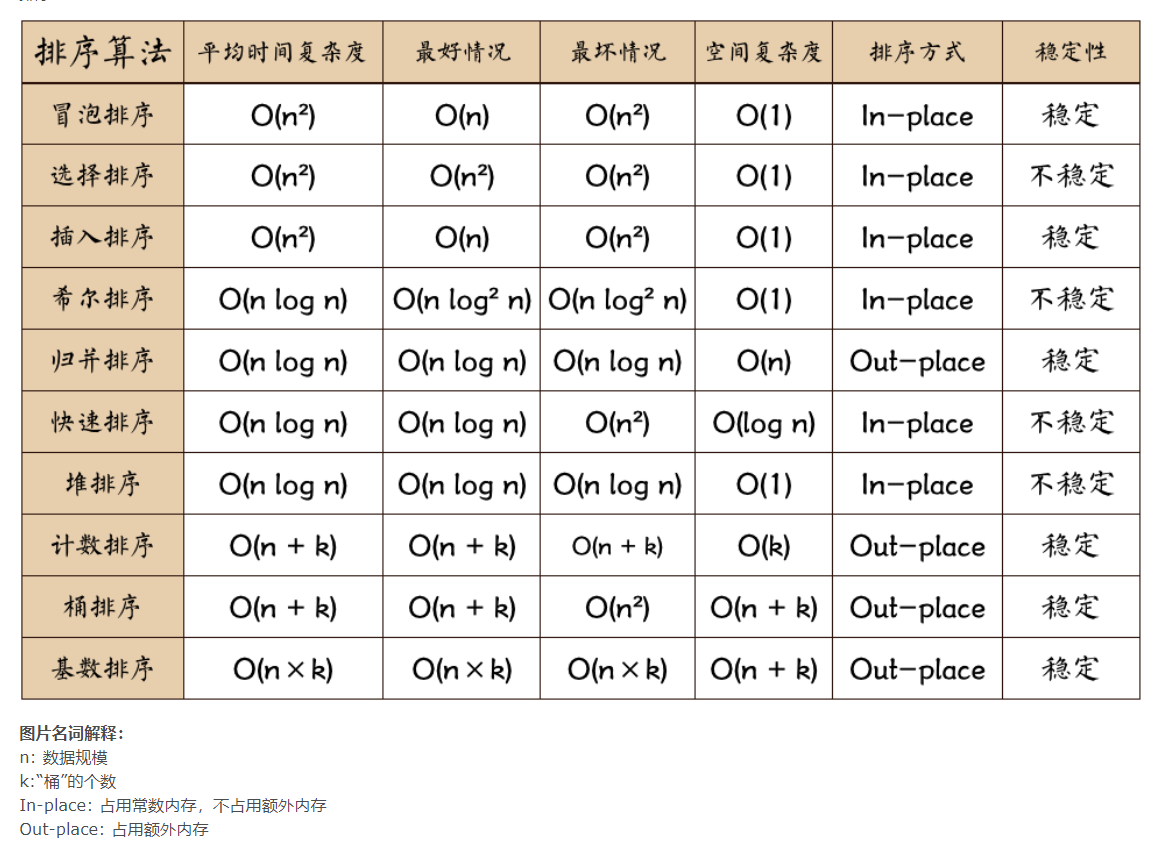
1.11 总结
2 外排序
所谓外排序,顾名思义,即是在内存外面的排序,因为当要处理的数据量很大,而不能一次装入内存时,此时只能放在读写较慢的外存储器(通常是硬盘)上。
外排序通常采用的是一种“排序-归并”的策略。
- 在排序阶段,先读入能放在内存中的数据量,将其排序输出到一个临时文件,依此进行,将待排序数据组织为多个有序的临时文件;
- 而后在归并阶段将这些临时文件组合为一个大的有序文件,也即排序结果。
案例:
外排序的一个例子是外归并排序(External merge sort),它读入一些能放在内存内的数据量,在内存中排序后输出为一个顺串(即是内部数据有序的临时文件),处理完所有的数据后再进行归并。比如,要对900MB的数据进行排序,但机器上只有100 MB的可用内存时,外归并排序按如下方法操作:
- 读入100 MB的数据至内存中,用某种常规方式(如快速排序、堆排序、归并排序等方法)在内存中完成排序。
- 将排序完成的数据写入磁盘。
- 重复步骤1和2直到所有的数据都存入了不同的100 MB的块(临时文件)中。在这个例子中,有900 MB数据,单个临时文件大小为100 MB,所以会产生9个临时文件。
- 读入每个临时文件(顺串)的前10 MB( = 100 MB / (9块 + 1))的数据放入内存中的输入缓冲区,最后的10 MB作为输出缓冲区。(实践中,将输入缓冲适当调小,而适当增大输出缓冲区能获得更好的效果。)
- 执行九路归并算法,将结果输出到输出缓冲区。一旦输出缓冲区满,将缓冲区中的数据写出至目标文件,清空缓冲区。一旦9个输入缓冲区中的一个变空,就从这个缓冲区关联的文件,读入下一个10M数据,除非这个文件已读完。这是“外归并排序”能在主存外完成排序的关键步骤 – 因为“归并算法”(merge algorithm)对每一个大块只是顺序地做一轮访问(进行归并),每个大块不用完全载入主存。
参考文献
经典排序算法总结与实现
数据结构与算法系列 目录
十种排序算法总结(冒泡、插入、选择、希尔、归并、堆、快速,计数,桶,基数)
图解排序算法(四)之归并排序
排序算法——归并排序
计数排序、基数排序和桶排序
计数排序、桶排序和基数排序
外排序
外排序-维基百科